

抗生素滥用是导致细菌耐药性问题产生的重要原因之一。耐药基因一旦产生,即便停止使用抗生素仍可在环境中存在多年,对人类和动物的健康造成威胁。在水产养殖中,长期使用抗生素会导致水产动物的选择压力,引起人类和鱼类病原体之间的水平基因转移[1]。目前,在产气单胞菌中已经发现了许多携带世界各地不同水产养殖地点的抗生素耐药性基因的可移动遗传元件[2]。因此,迫切需要找到不易产生耐药性的抗生素替代品,在不损害公众健康的情况下控制水产养殖中的病原菌感染。
抗菌肽(antimicrobial peptides,AMPs)是由基因编码的、分子质量小于10 ku的多肽。AMPs是机体对抗多种微生物病原体的第1道防线,因此也被称为宿主AMPs。AMPs具有广谱抗菌性、热稳定性、不易产生耐药性的优点,被认为是最具潜力的抗生素替代物[3]。鱼类可以通过分泌多种AMPs来持续抵抗病原体的侵袭。AMPs主要来源于黏液层,形成了抵御病原体入侵的保护性屏障,在对细菌、真菌、病毒和其他病原体的先天防御中发挥着重要作用。1980年,Primor等[4]首次从鱼中发现第1个AMPs家族Pardaxin,其序列中含有氨基酸33个残基,具有α-螺旋结构。目前已经在鱼类中鉴定出150余种AMPs,并根据其序列组成分成以下几个家族:Piscidins、Pardaxins、Cathelicidins、防御素、铁调素、组蛋白衍生肽等[5⇓-7]。
目前,AMPs的应用主要集中在治疗病原菌感染和免疫调节等方面。虽然一些AMPs已经进入临床阶段,但是天然AMPs抗菌活性差、细胞毒性高、体内稳定性差等缺陷仍是阻碍AMPs进一步应用的难题。因此,为了克服这些缺点,有必要进一步探索AMPs的结构特征和作用机制,提高其活性、稳定性和靶向性,同时降低其细胞毒性。本文综述了近年来鱼源AMPs的作用机制、分子设计与优化策略和应用,旨在提供对AMPs的全面了解和认识,为AMPs的临床开发和应用提供新思路。
1 AMPs的作用机理
1.1 膜损伤机制
带正电荷的AMPs通过与带负电荷的细菌膜相互作用,导致膜渗透性增加并引起细胞膜溶解和内容物外泄来发挥抗菌活性。首先,AMPs通过与细菌膜的静电作用接近细胞质膜,与微生物膜结合,并与细胞质膜的阴离子成分相互作用。在此之前,AMPs必需穿过荚膜多糖和细胞壁的其他成分,例如革兰氏阴性菌的脂多糖(LPS)和革兰氏阳性菌的脂磷壁酸(LTA)和肽聚糖(PGN)。随后,AMPs通过与疏水性残基与两亲性结构的相互作用插入脂质双分子层[8-9]。最初的插入一般发生在与脂质双分子层外小叶平行的方向上,随着浓度的增加,AMPs倾向于与表面垂直的方向,达到导致脂质易位和膜结构改变的临界浓度[8,10]。这些变化包括细菌膜变薄、细菌膜曲率的改变、静电的改变、孔隙的形成以及双分子层渗透屏障的扰动[11]。通过以上细菌膜结构的改变,AMPs可以在细菌膜中重新定向并转移到细胞质中,介导细胞膜的破坏,最终导致细菌死亡。目前,已经提出了4种常见模型来解释AMPs对细胞膜的渗透作用与破坏机制,即桶板模型(barrel-stave model)、环孔模型(toroidal-pore model)、地毯模型(carpet model)和聚集模型(aggregate model)[3](图1)。
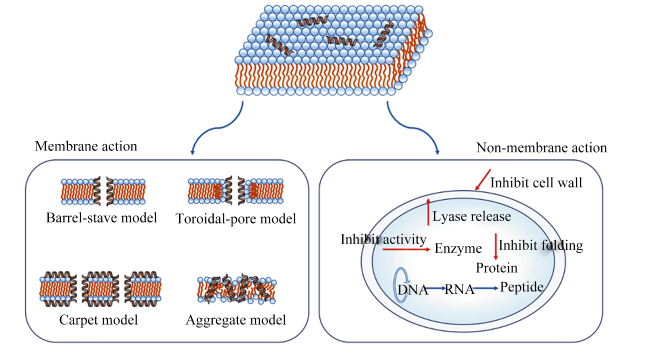


图1 AMPs的抗菌机制模型Membrane action:膜损伤机制;Non-membrane action:非膜损伤机制;Barrel-stave model:桶板模型;Toroidal-pore model:环孔模型;Carpet model:地毯模型;Aggregate model:聚集模型;Inhibit cell wall:抑制细胞壁;Lyase release:裂解酶释放;Inhibit activity:抑制活性;Enzyme:酶;Inhibit folding:抑制折叠;Protein:蛋白质;DNA:脱氧核糖核酸 deoxyribonucleic acid;RNA:核糖核酸 ribonucleic acid;Peptide:肽。 Fig.1 Models of antibacterial mechanisms of AMPs[3] |
2)环孔模型。AMPs的极性基团与脂质双分子层的极性基团结合,垂直插入到细菌细胞膜内,造成其疏水区域发生移位,在细胞膜脂质头部形成裂口,诱导脂质单分子层不断弯曲,最终导致细胞膜两侧的片层结构相连,形成跨膜环孔,造成胞内生物大分子的泄露[14]。在该模型中,脂质的疏水性和亲水性构象发生了改变,AMPs总是与脂质的头部相互作用,AMPs之间互不干涉,不存在特定肽-肽相互作用。
4)聚集模型。AMPs与阴离子细胞质膜结合,迫使AMPs和脂质形成肽-脂质复合物胶束[17]。与地毯模型不同的是,AMPs和脂质形成的通道允许离子和细胞内物质泄漏,造成细胞死亡。这些通道也可能帮助AMPs转移到细胞质中并发挥功能。
1.2 非膜损伤机制
2 鱼源AMPs的分子设计与优化策略
2.1 天然AMPs的改造
2.1.1 氨基酸替代
对天然AMPs某些特定位点进行氨基酸替代是最常见的AMPs结构优化策略。根据AMPs的两亲性和疏水性改变氨基酸分布可以提高AMPs的抗菌活性。色氨酸(Trp)和苯丙氨酸(Phe)等芳香族氨基酸有利于AMPs两亲性结构的形成,赖氨酸(Lys)、亮氨酸(Leu)、缬氨酸(Val)、异亮氨酸(Ile)、丙氨酸(Ala)和脯氨酸(Pro)等疏水性氨基酸可增加疏水性进而提高AMPs的抗菌活性。Zhang等[18]以美洲拟鲽(Pseudopleuronectes americanus)中提取的肽Pleurocidin作为模板,用Lys或Phe取代肽Pleurocidin序列中的部分氨基酸,得到具有高疏水性和适宜氨基酸长度的α-螺旋肽类似物Pm11。最小抑菌浓度(minimum inhibitory concentration,MIC)结果表明,肽Pm11对变形链球菌(Streptococcus mutans)、血链球菌(Streptococcus sanguinis)和远缘链球菌(Streptococcus sobrinus)具有明显的抑菌活性。此外,通过在N末端用Lys、精氨酸(Arg)和Trp取代盲鳗(Myxiniformes)表皮黏液的黏菌素Myxinidin的关键残基得到的AMPs在高盐条件下仍显示出强大的抗菌活性[19-20]。
需要注意的是,疏水性的增加可能会增加AMPs对细胞的溶血活性和细胞毒性。在不改变两亲结构的情况下,Sung等[21]通过Arg或Ser取代得到了肽Pleurocidin的类似物anal-R和anal-S。研究结果表明,肽类似物anal-R和anal-S的疏水性和α-螺旋构象有所降低,溶血活性也显著下降。Kumar等[22]通过用Ala或Val依次取代Ile5、Ile9和Ile16设计获得了6种Piscidin-1类似物。与肽Piscidin-1相比,单一Ala取代的肽类似物对哺乳动物的细胞毒性显著降低,同时保留了Piscidin-1的抗菌和抗内毒素活性。单一Val取代的肽Piscidin-1类似物表现出比相应位置Ala取代的类似物更高的细胞毒性,但抗内毒素活性也相应提高。Tripathi等[23]将来源于真鲷(Chrysophrys major)的肽Chrysophsin-1中GXXXXG基序的甘氨酸(Gly)残基用Ala、Val和Pro取代,Pro取代的肽Chrysophsin-1类似物对哺乳动物的细胞毒性显著降低,且在生理盐离子浓度、血清和高温条件下仍具有抗菌活性。Lee等[24]在研究来源于石斑鱼(Epinephelus coioides)的肽Piscidin-1疏水和亲水区域附近的Val作用时发现,Lys取代Val10得到的Pis-V10K类似物的α-螺旋倾向性有所提升,MIC与肽Piscidin-1相近,但其细胞毒性却大大降低。Yuan等[25]基于肽Piscidin-1利用Ala和Pro取代了Gly8和Gly13得到了肽Pis-1AA和Pis-1PG,结果表明,肽Pis-1AA具有最为稳定的α-螺旋结构;脂肽相互作用分析表明,肽Piscidin-1和Pis-1AA与两性离子二脂酰磷脂酰胆碱(DOPC)脂质双分子层的相互作用强于肽Pis-1PG。
电荷数是影响AMPs活性的另一主要因素。Hazam等[26]以肽Piscidin-2为模板,在不改变疏水性的条件下,通过用Lys取代Gly增加了净正电荷数,产生的肽TP2-5衍生物表现出显著的杀菌效力。Cashman-Kadri等[27]通过Lys和Leu取代鲣鱼(Katsuwonus pelamis)分离的肽SJGAP中的阴离子残基谷氨酰胺(Gln)和天冬氨酸(Asp),增加了净正电荷数,肽SJGAP类似物对大肠杆菌(Escherichia coli)和铜绿假单胞菌(Pseudomonas aeruginosa)的MIC达到50 μg/mL,与肽Magainin-2的抗菌活性相当。Jeong等[28]利用带正电的Lys取代肽Piscidin-1中Gly8得到类似物Pis-1[NkG],比与肽Piscidin-1相比,肽Pis-1[NkG]显示出较高的抗菌活性,具有更强的细菌细胞选择性。Li等[29]用带正电荷的Arg和Lys取代干扰素(IFN)-I序列中的非带电的极性残基谷氨酸(Glu)、Asp和苏氨酸(Thr)。设计得到的肽P5和肽P9对耐甲氧西林金黄色葡萄球菌(MRSA)具有较强的抗菌活性,且对人血细胞和肾上皮细胞无明显的溶血活性和细胞毒性。Gong等[30]以斑马鱼AP10为亲本肽,用Ile和Trp分别取代肽AP10的Gly8和蛋氨酸(Met)9得到肽AP10W,结果表明,肽AP10W对革兰氏阴性菌和革兰氏阳性菌的MIC为20~25 μg/mL,且对哺乳动物细胞没有毒性。然而,即使在同一序列中,Trp位置的不同,也会影响AMPs的抗菌效果。Trp分别位于肽AP3和肽APX序列的C端和N端,但肽APX对金黄色葡萄球菌(Staphylococcus aureus)和大肠杆菌的MIC值高出肽AP3的2~4倍[31]。此外,与来源于大黄鱼(Pseudosciaena crocea)的肽Pc-pis相比,通过在其羧基端插入组氨酸(His)设计的类似肽Pc-pis-His表现出更强的抗菌活性[32]。
2.1.2 肽链截断
将AMPs中非必需氨基酸截断,有利于降低AMPs的合成成本。Zhang等[33]以来源于罗非鱼(Oreochromis niloticus)的肽Oreoch-2为先导化合物,采用截断策略,合理设计并评估了6种Oreoch-2类似物对革兰氏阳性菌和革兰氏阴性菌的作用。其中,肽ZN-5和肽ZN-6被鉴定为广谱有效AMPs,抗菌活性略优于亲本肽Oreoch-2。此外,肽ZN-5和肽ZN-6对生理环境具有良好的稳定性,对细菌细胞的选择性远高于对哺乳动物细胞的选择性。Wang等[34]以斑马鱼磷光素C端的肽Pt5为亲本,通过截断亲本序列和氨基酸替换策略得到了肽Pt5-1c。肽Pt5-1c对LPS、LTA和PGN具有较高的亲和力,对包括多重耐药菌在内的革兰氏阴性菌和革兰氏阳性菌的MIC为1.2~4.8 μmol/L,而对哺乳动物细胞却几乎没有细胞毒性。通过截断肽Pleurocidin N端和C端区域合成的Pleurocidin类似物Ple (1-22)、Ple (4-25)、Ple (1-19)和Ple (7-25)表现出对真菌的抗菌活性,同时对人红细胞无溶血作用[35]。
2.1.3 肽链杂合
肽链杂合可以结合不同AMPs的优势到新的结构中,得到兼具多种AMPs优点的高效低毒杂合AMPs。Tan等[36]将源自文昌鱼(Branchiostoma japonicum)的肽AMP1-6与细菌信息素杂合,设计合成了肽P-6、S-6和L-6。功能试验显示,肽P-6、S-6和L-6均具有杀灭革兰氏阴性菌鳗弧菌(Vibrio anguillarum)、门多萨假单胞菌(Pseudomonas mendocina)、副溶血性弧菌(Vibrio parahaemolyticus)和革兰氏阳性菌藤黄微球菌(Micrococcus luteus)、李斯特菌(Listeria monocytogenes)的能力,并能增加细胞内活性氧(ROS)水平。
2.1.4 肽链修饰
C端酰胺化和N端乙酰化修饰AMPs的末端位点,可以提高AMPs的抗菌活性。酰胺基结合改善了AMPs与细菌细胞膜的相互作用,从而提高了AMPs的抗菌效力[37]。Jung等[38]对肽Pleurocidin进行研究时,设计了一种由全D型氨基酸组成的合成对映体肽all-D-Ple,合成的肽all-D-Ple的抗真菌活性是肽Pleurocidin的2倍,并表现出对多种蛋白酶的抗性。Kumar等[39]通过将Thr替换为L/D-Lys残基,设计了新型的肽Piscidin-1类似物,L/D-Lys取代的类似物的细胞毒性显著降低,表现出与肽Piscidin-1相似或更高的抗菌活性。此外,肽Piscidin-1类似物更好地抑制了LPS诱导的人髓系白血病单核细胞(THP-1)的炎症反应。肽Gadusciin-1是一种源自大西洋鳕(Gadus morhua)的富含His的AMPs,可以分别在N-末端和C-末端配位2个铜离子(Cu2+)。研究结果证实了Cu2+的结合是抗菌活性增加的主要的原因[40]。Lombardi等[41]报道了一种自组装纳米结构AMPs的设计的策略,将盲鳗表皮的肽WMR连接到1个脂肪族残基的肽段PA上,该肽段包含连接到末端Lys的ε氨基上的脂质尾部(C19H38O2),产生了新的肽WMR-PA。与肽WMR相比,肽WMR-PA显示出自组装成稳定的纳米纤维结构,显著抑制了铜绿假单胞菌和白色念珠菌(Candida albicans)的生物膜形成,并根除了已经形成的生物膜。
2.2 AMPs的全新设计
AMPs的全新设计是利用较少种类与有限数量的氨基酸,通过特定排布得到全新序列AMPs。相较于天然AMPs,全新设计可以定向优化AMPs的特定功能,降低细胞毒性和免疫原性,提出适用性更强的AMPs设计模板,提高AMPs的开发效率,降低AMPs合成成本[42]。Hussain Bhat等[43]设计并合成了一种组成简单、具有强大抗菌活性的短肽RY12WY,分子对接研究结果表明,该肽对温和气单胞菌(Aeromonas sobria)的溶血素和外膜蛋白具有较强的亲和力,对温和气单胞菌、嗜水气单胞菌(Aeromonas hydrophila)、迟钝爱德华氏菌(Edwardsiella tarda)、金黄色葡萄球菌、副溶血性弧菌、铜绿假单胞菌和大肠杆菌的MIC和最小杀菌浓度(minimum bactericidal concentration,MBC)范围分别为0.98~500 μmol/L和4~650 μmol/L。
2.3 基于计算方法的AMPs的预测
随着生物信息学的快速发展,通过计算方法来预测AMPs及其功能类型成为一种有效手段。基于计算方法的AMPs的预测是通过分析大量AMPs数据,挖掘AMPs生物特征与活性功能之间的关系,依靠智能计算的方式,提炼出不易发觉的规律和关联的一种预测。这种预测方法具有精度高、成本低、高效快捷、可操作性强等优点[44]。
2.3.1 AMPs生物信息数据库
目前,已经建立的AMPs数据库有10余种,包括APD、DBAASP、CAMP、dbAMPs、ANTI-MIC、YADAMP、LAMP、DRAMP、CyBase和PenBese,主要用于数据资源的收录和分析[45]。数据库通常包含了AMPs的氨基酸序列、物理化学性质、抗菌活性等注释信息。部分数据库还包含了序列比对、临床研究介绍和活性预测等信息。使用者可以从中提取需要的信息,利用数据库的各类工具对数据进行处理。目前,越来越多的AMPs数据库被用于识别、预测和设计AMPs衍生物。为了研究新尖吻银鲛(Neoharriotta pinnata)分离的组蛋白H2A衍生肽Harriottin-1的抗微生物活性,CAMP被用于对其进行预测。肽Harriottin-1被预测具有强大的抗菌和抗癌性能,研究结果证实了重组产生的肽rHar-1在25 μmol/L下除了抗癌活性外还表现出强大的抗菌活性[46]。Conceicao等[47]以纳氏海蟾鱼(Thalassophryne nattereri)毒液中获得的肽CART为基础,利用AMPA算法设计得到的类似物Tn CRT2和Tn CRT被证实在2.1~13 μmol/L的浓度内具有生物学活性。此外,研究人员还使用APD3、CAMP、AmpGram、C2Pred和CellPPD等网络服务器在肽CART中鉴定出19个新的AMPs,使用Boman指数分析每种AMPs的膜结合潜力和细胞位置后发现,其中2个AMPs表现出较高的膜结合潜能[48]。Houyvet等[49]基于APD3和CAMP的计算机分析功能筛选了具有潜在抗菌活性的AMPs序列,合成的9条长度小于25个氨基酸的AMPs均可形成α-螺旋结构,疏水性为30%~70%,MIC低于25 μmol/L。部分AMPs(肽VA20和FK19)具有溶血作用,而肽GR21在浓度为200 μmol/L时对人血细胞的溶血率小于10%。
2.3.2 AMPs的预测方法
1)基于经验分析的预测方法。该预测方法是根据已知的经验规则或者模式对某类AMPs一些理化性质和抗菌活性之间的关联进行统计或建模来对该类AMPs进行识别的一种方法[44]。这种方法的主要预测方式是基于同类AMPs样本进行训练,一般没有通用的量化指标对这类方法的性能进行统一地评估和比较。常见的预测方法有序列比对、定量构效关系(quantitative structure-activity relationship,QSAR)模型、模糊逻辑模型、语言模型和分子动力学(molecular dynamics,MD)仿真等[50]。其中,最常用的序列比对工具主要包括FASTA、BLASTP、CLUSTALW、Sminth-Waterman算法、隐马尔可夫模型(HMMER)等[44]。APD和YADAMP数据库的预测工具就采用了BLAST序列比对程序对AMPs进行预测。如果发现待测样本具有与AMPs序列相似的特征,则推断该多肽具有很高的概率为AMPs。Wang等[51]使用序列比对和特征选择方法的组合来设计计算模型,更准确地对AMPs进行了分类。QSAR通过定量描述AMPs的结构或理化性质,借助数学和统计学方法建立抗菌活性和AMPs之间的量化模型。Chen等[52]利用生物信息学分析与MD相结合的策略,识别了肽Piscidin的特定功能区域,得到了一种有效且无毒的类似物Pi-A-1,可以用作抗生素佐剂来抵抗MRSA病原体。
2)基于机器学习(machine learning,ML)的预测方法。该预测方法是通过对AMPs的已知数据信息进行学习,进行推理、归纳、综合或模型拟合后,找出AMPs的特点和规律,并将其推广到未知AMPs数据来进行预测的方法[44]。该方法采取有监督学习方式将AMPs预测转变为分类问题,主要适用于模型相对复杂且缺乏一般性理论的AMPs的预测。近10年来,ML预测方法的重点已经转移到一种高度数据驱动的方法上[50]。ML的基本流程主要包括学习、预测和验证3个阶段[44]。在第1阶段,先从文献或公共数据库收集AMPs序列,构建AMPs数据集;然后,通过分类算法设计和相关参数学习训练得到相应的预测模型,并将待测AMPs提交给训练好的预测模型,通过计算机处理输出相应的预测结果。最后,根据不同的评价指标进行检验和优化调整[45]。由于ML无法直接读取AMPs的序列排布、理化性质、抗菌活性等信息,所以必须先提取AMPs特征并用数学描述来表达特质,因此,ML的核心问题是如何设计具有高精度的分类算法。目前,ML的预测方法包括二分类学习法、多分类学习法和多标签学习法[44]。利用二分类学习法对AMPs进行预测时,通常将全部AMPs样本划分为2类,即AMPs和非AMPs,常见的算法包括人工神经网络(artificial neural network,ANN)、支持向量机(support vector machine,SVM)和随机森林(random forest,RF)等[45]。Lata等[53]开发了一种基于ANN、SVM和QSAR的AMPs分类工具,发现了AMPs的C端和N端中的独特基序。Chersakov等[54]使用高通量筛选方法,对数千种AMPs的抗菌效果进行了ANN模型训练,发现对多药耐药菌有效的高效AMPs。Torrent等[55]通过SVM对AMPs进行了分类与预测,预测准确率达到了75%~90%。Okella等[56]基于SVM在APD3提交的127种鱼源AMPs中,根据其理化性质筛选出基序候选物。其中,肽Pleurocidin中第2~19位氨基酸的A15_B基序表现最强的抗菌潜力。Maccari等[57]使用RF模型设计并验证了2种天然AMPs和1种具有非天然氨基酸AMPs的抗菌活性。随着预测手段的发展,人们逐渐将AMPs的样本属性扩展到多种类别。Lata等[58]和Joseph等[59]基于AMPs序列特征分别利用SVM和RF算法,采用“一类对其余”策略对二分类学习法进行改进,建立了多分类学习法,将AMPs的类别扩展到了至少3个。随着研究的不断深入,多标签学习法被用于处理AMPs样本序列和抗菌活性存在“一对多”关系数据[44]。
3 鱼源AMPs在水产养殖中的应用
3.1 抑制细菌和真菌生长
AMPs最主要的作用是抑制细菌和真菌的生长。Li等[60]在研究来源于鲶鱼(Silurus asotus)表皮黏液的肽CF-14的抗菌活性时发现,肽CF-14能够通过泄漏细胞内容物对腐败希瓦氏菌(Shewanella putrescentiae)表现显著的抑制作用。Rajapaksha等[61]设计并表征的肽Octopromycin可以通过多靶点相互作用实现对鲍曼不动杆菌(Acinetobacter baumannii)的快速抑制。研究人员从生鱼速激肽中提取了一种AMPs,使用预测程序筛选出的肽RM12显示出对多重耐药菌和铜绿假单胞菌的抗菌活性[62]。鳗弧菌是与食用海产品有关的食源性疾病暴发的最重要病原体。从马尼拉蛤(Ruditapes philippinarum)中鉴定得到的防御素亚型Rpdef1-α不仅对弧菌具有广谱抗菌活性,还能抑制细菌生物膜的形成[63]。此外,基于鱼源AMPs设计得到的肽(3)K(5)K(7)G对耐药弧菌表现出良好的生物学活性,在2~16 μmol/L时显著抑制其生长。此外,肽(3)K(5)K(7)G在64 μmol/L处理4 h后,可杀死99%以上的溶藻弧菌(Vibrio alginolyticus)[64]。从长蛸防御蛋白cDNA序列中设计合成的肽Octominin在体内对白色念珠菌具有良好的抗菌活性[65]。
此外,AMPs还可与其他抗菌剂协同,发挥抗菌功效。Assane等[66]评估了几种合成AMPs单独或与氟苯尼考、土霉素或硫霉素联合使用对病鱼分离出的不同致病菌的疗效,研究表明,合成的AMPs对简达气单胞菌(Aeromonas jandaei)、弗氏柠檬酸杆菌(Citrobacter freundii)、无乳链球菌(Streptococcus agalactiae)、加氏乳球菌(Lactococcus garviae)和河流弧菌(Vibrio fluvialis)均具有抗菌活性。Huang等[67]通过在基于低聚胍的AMPs中引入具有双选择作用机制的可降解连接剂得到新的拟肽,新的拟肽能够与其他抗生素的协同,并拥有较高的治疗指数。
3.2 防治寄生虫
AMPs除了具有上述抗细菌和抗真菌活性外,还表现出良好的抗寄生虫活性。Choi等[68]从星突江鲽(Platichthys stellatus)中鉴定并合成了肽PsPSAPL-1和PsPSAPL-2,结果证实,肽PsPSAPL-1和PsPSAPL-2能够有效杀死贪食迈阿密虫(Miamiensis avidus)。
3.3 提高存活率
Nicolas等[69]研究表明,从天然AMPs中获得的环七肽Pep16和Pep19在轻度和重度败血症模型中对斑马鱼胚胎无细胞毒性。在感染鲍曼不动杆菌后,经肽Octopromycin处理的斑马鱼的存活率(37.5%)显著高于用磷酸盐缓冲液(PBS)处理的斑马鱼(16.6%)[61]。Lv等[63]研究表明,肽Rpdef1-α转录物基因的敲除导致马尼拉蛤在鳗弧菌攻击后的累积死亡率显著增加。与肽Rpdef1-α孵育后,血细胞的吞噬作用和趋化能力可以显著增强。同时,以低聚胍为基础的拟肽在斑马鱼体内没有明显的毒性,并且可以显著提高斑马鱼在伤口感染后的存活率。最近的研究也报告了某些AMPs对各种类型的癌症细胞具有选择性毒性。研究表明,肽Pleurocidin和其C端氨基化衍生物Ple-a对癌症细胞株也表现出显著的细胞毒性,半抑制浓度(IC50)为11~340 μmol/L,肽Ple-a可以抑制人非小细胞肺癌细胞A549的自噬,并在处理后48 h诱导细胞凋亡[70]。
4 小结与展望
目前,鱼源AMPs的分子设计与优化策略主要是基于对天然AMPs的氨基酸替换。利用单一或多个氨基酸替换对AMPs进行结构优化,虽然提高了AMPs的抗菌活性,但仍然对AMPs的结构与功能关系缺乏规律性认识。因此,在今后的研究中,应系统开展AMPs的分子设计与优化研究,深入解析AMPs的结构与功能关系。此外,应用于水产养殖业的AMPs大部分为天然AMPs,部分应用的水产养殖业的合成AMPs也仅停留于体外研究,新型设计的AMPs在进行水产动物体内应用的案例较少,缺乏深入地研究。AMPs的开发需要微生物学、计算机学和化学合成等多种学科的交叉融合,除传统的AMPs的结构改造和修饰方法外,还需要通过计算机辅助技术和高通量筛选技术加快AMPs的开发。最近,许多计算方法和工具已经应用于进行AMPs的预测,利用数据库对AMPs的研究可能成为开发新型AMPs的关键。随着AMPs分子设计与优化策略的不断进步,AMPs将在农业、医药和食品等领域进行应用,成为更加安全、高效、绿色的抗生素替代物。