RESEARCH PAPER

Study on Prediction Model of Nutrient Requirements for Growing-Finishing Pigs Based on Classification Algorithms

  • LI Yingying , 1, 2 ,
  • ZHANG Shuya 1, 2 ,
  • CAO Hongrui 1, 2 ,
  • ZHOU Yujun 1, 2 ,
  • ZHANG Shuai , 1, 2, **
Expand
  • 1 College of Animal Science and Technology, China Agricultural University, Beijing 100193, China
  • 2 National Center of Technology Innovation for Pigs (North China Branch), Beijing 100193, China
** professor, E-mail:

*Contributed equally

Received date: 2024-12-30

  Online published: 2025-09-12

Abstract

Accurate assessment of nutrient requirements for pigs and realization of precise nutrition formulation are of great significance for improving feed resource utilization efficiency and promoting the development of the pig farming industry in China. This study aimed to construct a prediction model of the nutritional requirements for growing-finishing pigs based on classification algorithms by mining and analyzing existing literature data, and to identify the optimal model, thereby exploring the feasibility of classification algorithms in establishing more scientific and rational pig feeding standards. Literature published in the past decade regarding energy and amino acid requirements of “Duroc×Landrace×Yorkshire” pigs was systematically retrieved from the Web of Science database. Studies containing complete dietary nutrient levels and growth performance data were screened and compiled to form an initial dataset. Seventy-five percent of the initial dataset was allocated as the training dataset, and the remaining 25% as the validation dataset. Three machine learning algorithms-decision tree (DT), artificial neural network (ANN) and k-nearest neighbor (KNN)-were used to construct classification models. The results showed that the classification model based on the KNN algorithm performed best in predicting the nutrient requirements of growing-finishing pigs [with k=4, the misclassification rate (MCR) in the validation dataset was 0.374]. The KNN algorithm can be successfully applied to construct a classification model for predicting the nutrient requirements of “Duroc×Landrace×Yorkshire” growing-finishing pigs, providing foundational support for establishing more scientific pig feeding standards and precision feeding technologies.

Cite this article

LI Yingying , ZHANG Shuya , CAO Hongrui , ZHOU Yujun , ZHANG Shuai . Study on Prediction Model of Nutrient Requirements for Growing-Finishing Pigs Based on Classification Algorithms[J]. Chinese Journal of Animal Nutrition, 2025 , 37(9) : 6302 -6316 . DOI: 10.12418/CJAN2025.511

精准评估猪营养需要量,并以此作为饲粮设计的依据,是合理利用饲料资源、提高饲料转化效率和实现精准饲喂的工作基础[1]。净能(net energy,NE)和标准回肠可消化氨基酸(standardized ileal digestible amino acid,SID AA)分别是当前最精准的猪能量和氨基酸评价体系。然而,这些指标的测定需要依赖动物试验和湿化学法,通常耗费大量人力物力,因此在生产中较难普及,而基于已测定的数据建立数学模型,可实现NE和SID AA的快速预测[2-5]。目前,国内外已有不少研究基于饲料原料的化学组分,建立了其在畜禽上有效能和SID AA的动态预测方程[5]。在营养需要量研究方面,法国国家农业科学研究院(INRAE)于2008年基于消化代谢、间接测热和比较屠宰等试验的数据积累,分别建立了生长猪和母猪的NE需要量动态预测模型并开发了相应软件InraProc[6]。在国内,广东省农业科学院动物科学研究所采用比较屠宰法建立了6~25 kg仔猪的体沉积曲线及蛋白质、能量需要量的动态模型[7-8]。此外,中国科学院亚热带农业生态研究所对生猪动态营养需求进行了更为详细的阐释,即以特定生产目标为导向,基于生猪遗传因素、生长阶段、生理状态、生长环境、养殖规模、市场行情和猪肉品质等因素,为生猪提供精准动态的营养供给[9]。但以上模型多以线性或非线性回归模型为主,而实际生产中变量之间往往不符合简单的线性或非线性关系。为了更好地表示拟合数据中的复杂关系,本研究团队前期在消化代谢和间接测热试验积累的“杜×长×大”生长育肥猪能氮平衡数据的基础上,基于机器学习中的人工神经网络(artificial neural network,ANN)算法建立了生长育肥猪NE需要量的动态预测模型[10]
机器学习是20世纪后期出现的一类能够从不同类型、不同维度的数据集中提取隐藏信息的数据整合方法[11]。分类算法是机器学习中监督学习任务为分离数据(分类)的一类算法[12]。目前,分类算法在植物营养学和人类营养学领域已得到广泛应用。例如,Dhal等[13]使用线性判别分析、支持向量机、决策树(decision tree,DT)和k-最近邻(k-nearest neighbor,KNN)算法分别构建模型,将分类算法应用于水培灌溉植物最佳营养物质供给水平的预测,发现支持向量机模型的拟合效果最佳,并根据该模型的分类结果给出了适用于不同输出类别的推荐营养指标浓度。Adidrana等[14]以水培生菜为试验对象,应用KNN算法对营养液酸碱度、总溶解固形物值和温度指标进行分类,以此来向微环境控制器提供命令,发现当k=5时KNN算法的准确率达93.3%。Qasrawi等[15]利用k-均值聚类(k-means clustering)和DT算法分析女大学生群体贫血与维生素和矿物质摄入的关系,发现除叶酸、维生素B6、维生素C、维生素B12和铁等已知贫血相关营养物质外,胆碱、维生素E、维生素B2、锌、镁、锰和磷等也可能与贫血发生有关。Sak等[16]在分析人工智能在营养科学研究中的应用时发现,ANN在食品成分研究和营养物质生产研究中占主导地位。在动物营养学领域,分类算法目前主要用于预测模式动物肥胖、代谢异常和营养不良等病理现象[17],而在动物营养需要量研究方面,机器学习算法尤其是分类算法的应用较少。此外,当前动物饲养标准多采用体重对营养需要量进行分类,但其分类标准由人为设定,缺乏科学的划分依据,机器学习中的分类算法则能够在此基础上提供更加科学合理的饲养标准设定依据。
因此,本研究拟在构建生长育肥猪营养需要量数据集的基础上,基于DT、ANN和KNN 3种常用分类算法构建生长育肥猪营养需要量动态预测模型,并对模型性能进行评估,以探究分类算法在构建更科学合理的猪饲养标准中的可行性。

1 材料与方法

1.1 数据收集

本研究对2012—2022年收录在Web of Science数据库中的SCI文献进行检索,检索主题的关键词为“pig”或“swine”和“growth performance”。检索后,按照如下标准筛选文献,摘录原始数据:1)试验动物为“杜×长×大”猪,采用随机对照试验设计,至少包含1个对照组,且每个试验组重复数≥4;2)试验饲粮为玉米-豆粕型饲粮,饲粮配方表及相应原料组成明确,且各原料营养参数能在《猪营养需要量》(GB/T 39235—2020)[18]中查询;3)试验结果记录了猪只在不同饲喂阶段的生长性能指标,包括体重、平均日增重(ADG)和平均日采食量(ADFI)。

1.2 数据提取

将筛选出的目标文献报道数据转录至Excel表格,确保每篇文献中各试验组饲粮的原料组成信息与试验猪的体重、ADG、ADFI及增重耗料比(G/F)数据一一对应。根据文献提供的饲粮配方表及原料组成信息,参照《猪营养需要量》(GB/T 39235—2020)[18]中的营养参数值重新计算各组饲粮的营养水平。本试验用于模型构建的饲粮营养指标包括NE、标准回肠可消化赖氨酸(standardized ileal digestible lysine,SID Lys)、标准回肠可消化蛋氨酸(standardized ileal digestible methionine,SID Met)、标准回肠可消化苏氨酸(standardized ileal digestible threonine,SID Thr)、标准回肠可消化色氨酸(standardized ileal digestible tryptophan,SID Trp)和标准回肠可消化缬氨酸(standardized ileal digestible valine,SID Val)含量。

1.3 数据预处理

1.3.1 探索离群值

对于包含大量不同来源数据的数据集,通常会因数据记录出错、测量失误或系统误差等原因产生不同程度的离群值[19]。若保留离群值构建模型,可能导致预测结果整体向离群值方向偏移,进而增大样本方差[20],使模型预测效果变差;反之,剔除离群值后构建模型,也可能导致预测结果向相反方向偏移,使样本方差降低[21]。对于某些特定模型而言,该过程可能增加过拟合风险。因此,正确界定和筛选离群值,合理讨论其去留,对准确认识数据特征分布、构建具有泛用性的预测模型至关重要。一般情况下,将数据可视化为箱线图、直方图和散点图的方式最常被用于寻找离群值[22]
本试验采用JMP Pro 14.0软件(SAS Institute Inc.,美国)离群值探索程序中的多元稳健拟合离群值工具筛选离群值,即通过可视化每条数据对应数据点到数据集多元正态分布中心的马氏距离(Mahalanobis distance)[23]来展现离群值的分布情况,马氏距离越小,证明该条数据中存在离群值的概率越低,反之越高。

1.3.2 归一化处理

在模型训练前对数据进行归一化处理,消除单位和取值范围对变量特征的影响。其操作流程为:对不同类型的变量特征数据采用相同规则进行放大或缩小,使处理后的数据均处于给定取值区间[0,1]内[24]。由于本试验中用于模型构建的猪生长性能和饲粮营养指标的取值范围相对稳定,因此选用机器学习预处理中最常用、计算简便且可解释性较强的最小最大值归一法对数据进行归一化[25]。计算公式如下:
X i '=[Xi-min(X)]/[max(X)-min(X)]。
式中:分母[max(X)-min(X)]是特征数据的极差,即该列数据中最大值与最小值的差值;分子[Xi-min(X)]是第i个特征值和最小值的差值。经该公式归一化处理后,数据取值范围限定在[0,1]区间内。
此外,为了更好地对表征模型预测结果的各项参数进行对比和评价,对输出变量进行反向归一化[26]以还原数据,使模型的拟合程度系数[如均方根误差(RMSE)]回归正常范围。计算公式如下:
Yi=[max(Y)-min(Y)]× Y i '+min(Y)。
式中: Y i '表示完成归一化之后第i个观测值导入模型之后的输出结果;Yi表示还原之后的预测值;max(Y)表示原始观测值的最大值;min(Y)表示原始观测值的最小值。

1.3.3 数据聚类

为分析参与建模数据的整体分布规律和聚簇结构特征,本试验将在生长性能、饲粮能量和氨基酸水平等变量上具有相似值的观测值划分成不同类别,并使用k-均值聚类算法对数据进行聚类。具体原理为:在多维空间构建不同类别的聚类中心,通过计算数据点到各聚类中心的距离,将其判定至距离最短的类别。不同指定聚类数的最终聚类效果依据立方聚类准则(cubic clustering criterion,CCC)值判定[27],CCC值越大表明聚类效果越好。通常认为,CCC值大于3时聚类效果理想。元分析得到的原始数据集在经预处理后,按照类别随机拆分为2个大小不同的子数据集。其中,包含75%数据的子集被定为训练集,剩余包含25%数据的子集被定为验证集。数据集的拆分使用JMP Pro 14.0软件的生成验证列功能,设置随机方式为分层随机。

1.4 数据建模

数据预处理后,以JMP Pro 14.0软件为建模工具,采用DT、ANN和KNN 3种分类算法训练分类模型。

1.4.1 训练DT模型

DT模型呈树状结构,由节点(node)和有向边(directed edge)构成[28]。其中,无后续分支的节点为叶节点(leaf node),代表最终分类结果;含后续分支的节点为内部节点(internal node),用于承载数据集中输入变量特征值的分支选择。树状结构根部是模型层次结构的起始部位,被称为根节点(root node),对应样本数据的输入变量[29]。该模型最终拟合程度的判定标准是熵值,熵值反映分支下样本种类的丰富性,样本类别越多,熵值越大;若分支下样本完全属于同一类别,则熵值为0[30]。因此,DT模型的训练逻辑是通过不断拆分节点以快速降低熵值。但过量拆分可能会导致数据的过度拟合[31],因此本试验采用剪枝技术来降低过度拟合的概率。按照上述方法训练DT模型,反复执行节点拆分,直到进一步的拆分无法再提高模型的预测准确性,即在验证集上,评价模型拟合程度的决定系数(R2)大于后续10次拆分所获得的R2时,算法结束运行。

1.4.2 训练ANN模型

ANN模型的结构包括输入层(input layer)、输出层(output layer)和位于二者之间的隐藏层(hidden layer)。在隐藏层中,设置有隐藏节点(hidden node),每个节点中实现数据转换作用的函数被称为激活函数(activation function)[32]。通常情况下,1个隐藏层即可构建出能以任意精度拟合连续函数的模型,且拟合精度由隐藏层的节点数决定[33]。本试验采用2种常用的激活函数:双曲正切函数(hyperbolic tangent function,Tanh)和高斯径向基函数(Gaussian radial basis function,GRBF)[34]。除层数和激活函数外,ANN需调节的超参数还包括学习率,学习率能够控制模型的收敛速度,取值通常在0.01到0.1之间。综上所述,本试验将ANN参数组设定成隐藏层数为1,学习率为0.1,惩罚方法为平方,历程数为100的模式,主要通过改变节点数和激活函数来调节模型拟合效果。

1.4.3 训练KNN模型

构建KNN模型时,算法将整个数据集作为训练集,计算待分类样本与所有训练样本的距离,选取距离最近的k个样本作为近邻。模型通过构建邻近的k个预测变量值与其他观测的预测变量值之间的联系,使这些观测值在多维空间中达到最小欧氏距离,以此来确定k值。处理分类问题时,预测值为k个最近邻中出现次数最多的类别。为保证结果可重现,建模前需设置随机种子[35]。本试验为确保不同算法构建的猪营养需要量预测模型具有可比性,使用了与DT和ANN模型相同的预测变量训练KNN模型。随机种子数设为1,通过调试不同k值完成KNN模型的构建。

1.5 模型筛选与评估

选用误分类率(misclassification rate,MCR)作为评价分类模型拟合程度的标准。MCR是评估分类模型性能的重要指标,用于衡量模型预测错误的样本占总样本的比例,其值越低表明模型的分类准确度越高[36]。本试验通过对比各模型中响应类别预测概率最高的结果,筛选出分类效果最佳的模型,并将该模型输出结论与k-均值聚类分类结果整合,得出一套生长育肥猪营养需要量推荐标准,并将其整理成表格的形式呈现。

2 结果与分析

2.1 文献筛选

文献检索结果如表1所示。通过Web of Science平台共检索到1 330篇SCI文献,按照设定的文献筛选标准逐步筛选后,最终从检索结果中筛选出120篇文献,用于初始数据集的数据提取。
表1 文献检索结果

Table 1 Results of literature search

数据库
Database
检索式
Search patterns
总数目
Total items
2012—2022年数目
Items from
2012 to 2022
相关文献数目
Items of relevant
literature


Web of Science
TS=(pig) 715 757 185 423 5 463
TS=(swine) 427 776 139 362 1 276
TS=(growth performance) 654 814 406 397 7 242
(TS=(pig) or TS=(swine)) and
TS=(growth performance)
28 446 13 488 1 330

相关文献数目为2012—2022年间排除兽医学、微生物学和遗传学等不相关研究领域后剩余的文献数量。

The items of relevant literature are the quantity of literature remaining after excluding irrelevant research fields such as veterinary medicine, microbiology and genetics during 2012 to 2022.

2.2 数据预处理和聚类结果

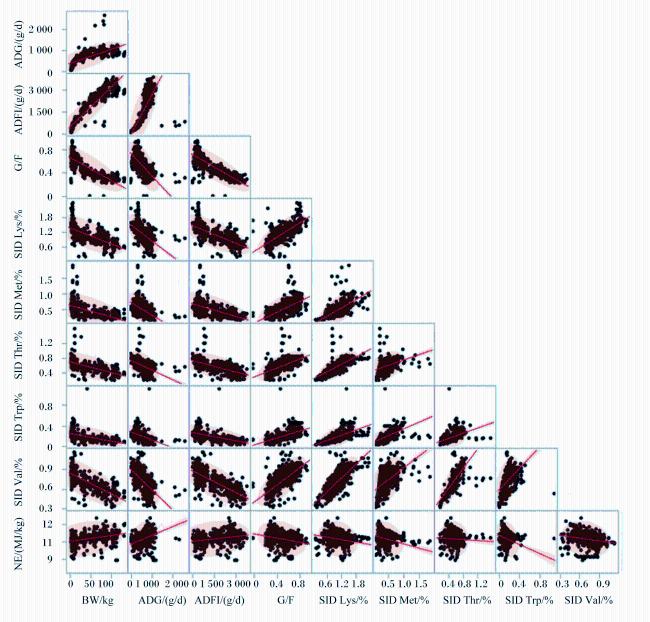
经过前文中所述的流程完成文献筛选和数据提取后,得到包含717个不同处理的原始数据集。参照《猪营养需要量》(GB/T 39235—2020)[18]中生长育肥猪的能量需要表对原始数据集进行初步检查。原始数据集的散点图矩阵(图1)显示,数据集中存在较多影响数据整体分布的离群值。因此,需对原始数据集开展离群值筛查,以识别并剔除异常数据点。
图1 原始数据集的散点图矩阵

BW:体重 body weight;ADG:平均日增重 average daily gain;ADFI:平均日采食量 average daily feed intake;G/F:增重耗料比 gain to feed ratio;SID Lys:标准回肠可消化赖氨酸 standardized ileal digestible lysine;SID Met:标准回肠可消化蛋氨酸 standardized ileal digestible methionine;SID Thr:标准回肠可消化苏氨酸 standardized ileal digestible threonine;SID Trp:标准回肠可消化色氨酸 standardized ileal digestible tryptophan;SID Val:标准回肠可消化缬氨酸 standardized ileal digestible valine;NE:净能 net energy。下图同 The same as below。

图片显示了原始数据集中数据的分布情况,其中每个点均代表1条完整数据,浅红色区域为95%置信椭圆,红色部分为趋势线。The image shows the distribution of data in the original dataset, where each point represents a complete piece of data, the light red area is the 95% confidence ellipse, and the red part is the trend line.

Fig.1 Scatterplot matrix of original dataset

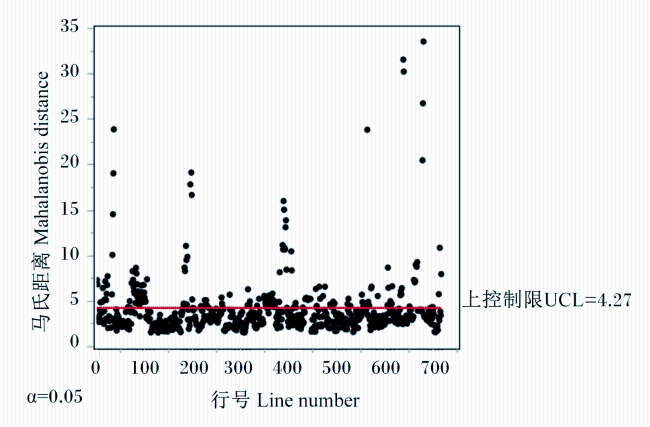
图2展示了原始数据集通过多元稳健拟合离群值工具进行离群值筛查的结果,图中的横轴表示原始数据集中的717个不同处理,纵轴表示数据集中10个不同列数据的马氏距离。马氏距离是衡量多维数据点与分布之间泛化距离的指标,能反映数据间的协方差关系。图中划线处表示α=0.05时系统给定的上控制限(upper control limit,UCL)距离为4.27。以该值为基准,剔除马氏距离大于4.27的193条离群值,剩余524条数据经过归一化处理后用于构建模型。
图2 原始数据离群值分析结果

红色线条表示α=0.05时的UCL距离为4.27。

Fig.2 Outlier analysis results of original dataset

The red line indicates the UCL distance of 4.27 at α=0.05.

表2为完成离群值剔除和验证列划分之后的数据描述性统计结果。由表2可知,训练集数据中猪的体重为6.83~119.30 kg,ADG为101~1 270 g,ADFI为179~3 613 g,G/F为0.24~0.86,饲粮NE为9.41~12.01 MJ/kg,SID Lys含量为0.36%~1.86%,SID Met含量为0.16%~0.92%,SID Thr含量为0.22%~0.87%,SID Trp含量为0.05%~0.40%,SID Val含量为0.37%~1.02%。
表2 数据预处理后的猪生长性能和饲粮营养水平的描述性统计结果

Table 2 Descriptive statistics results of pig growth performance and dietary nutrient levels after data preprocessing

项目
Items
生长性能Growth performance 营养水平Nutrient levels
体重
BW/kg
平均
日增重
ADG/(g/d)
平均日
采食量
ADFI/(g/d)
增重
耗料比
G/F
标准回肠可
消化赖氨酸
SID Lys/%
标准回肠可
消化蛋氨酸
SID Met/%
标准回肠可
消化苏氨酸
SID Thr/%
标准回肠可
消化色氨酸
SID Trp/%
标准回肠
可消化缬氨酸
SID Val/%
净能
NE/
(MJ/kg)
训练集Training dataset
样本量Sample number 393 393 393 393 393 393 393 393 393 393
最小值Min 6.83 101.0 179.0 0.24 0.36 0.16 0.22 0.05 0.37 9.42
最大值Max 119.30 1 270.0 3 613.0 0.86 1.86 0.92 0.87 0.40 1.02 12.02
极差Range 112.47 1 169.0 3 434.0 0.62 1.50 0.76 0.65 0.35 0.65 2.61
均值Mean 43.03 662.8 1 599.4 0.50 1.10 0.43 0.58 0.18 0.72 10.83
标准差SD 33.01 269.7 991.0 0.16 0.28 0.16 0.13 0.06 0.14 0.38
验证集Validation dataset
样本量Sample number 131 131 131 131 131 131 131 131 131 131
最小值Min 7.75 98.0 164.0 0.23 0.28 0.16 0.23 0.08 0.38 9.81
最大值Max 123.80 1 250.0 3 618.6 0.85 1.89 0.79 0.87 0.40 1.00 11.97
极差Range 116.05 1 152.0 3 454.6 0.62 1.61 0.63 0.63 0.31 0.62 2.17
均值Mean 46.04 665.4 1 652.7 0.50 1.09 0.43 0.58 0.17 0.71 10.84
标准差SD 37.47 288.2 1 057.3 0.16 0.31 0.17 0.14 0.06 0.14 0.38

表中饲粮营养水平(干物质基础)为基于《猪营养需要量》(GB/T 39235—2020)[18]中收录的“猪常用饲料原料描述及营养价值表”内各原料营养成分含量信息,根据文献资料中提供的饲粮配方计算所得。

The dietary nutrient levels (DM basis) in the table were calculated based on the nutrient composition information of each raw material in the “Table of Descriptive and Nutritional Values of Common Swine Feed Ingredients” included in Nutrient Requirements of Swine (GB/T 39235—2020)[18], combined with the dietary formulations provided in the literature.

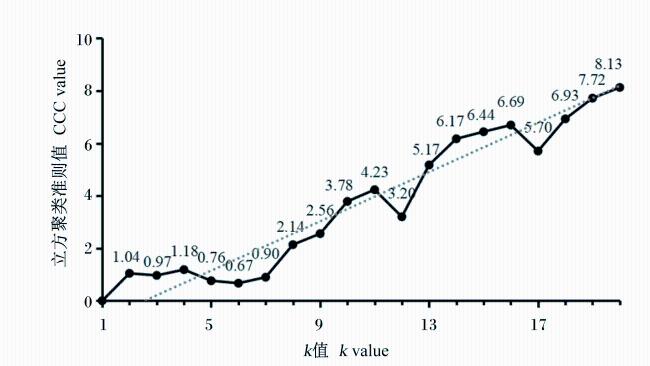
为筛选出适用于分类试验数据的最优聚类参数,将取值为1~20区间内的k值依次导入聚类程序,对筛选后的数据进行k-均值聚类分析。聚类完成后,以聚类数k值为横轴、不同k值聚类得到的CCC值为纵轴绘制折线图(图3)。结果显示,随着k值的增大,聚类模型的CCC值整体呈上升趋势。但过大的k值可能导致分析过程复杂化,无法准确界定各个分类对应的数据特征,降低聚类结果的可解释性,因此需要对k值范围加以限制。由图3可知,当k=4时,CCC值出现第1个峰值(1.18),但后续k值增加至8时,CCC值未呈现显著提升,当k=11时,CCC值出现第2个峰值(4.23),且k值进一步增大时聚类效果明显下降,因此选择k=11作为最终的k-均值聚类参数。
图3 聚类结果汇总

Fig.3 Summary of clustering results

虚线为CCC值随k值变化的整体趋势。The dashed line shows the overall trend of the CCC value with the k value.

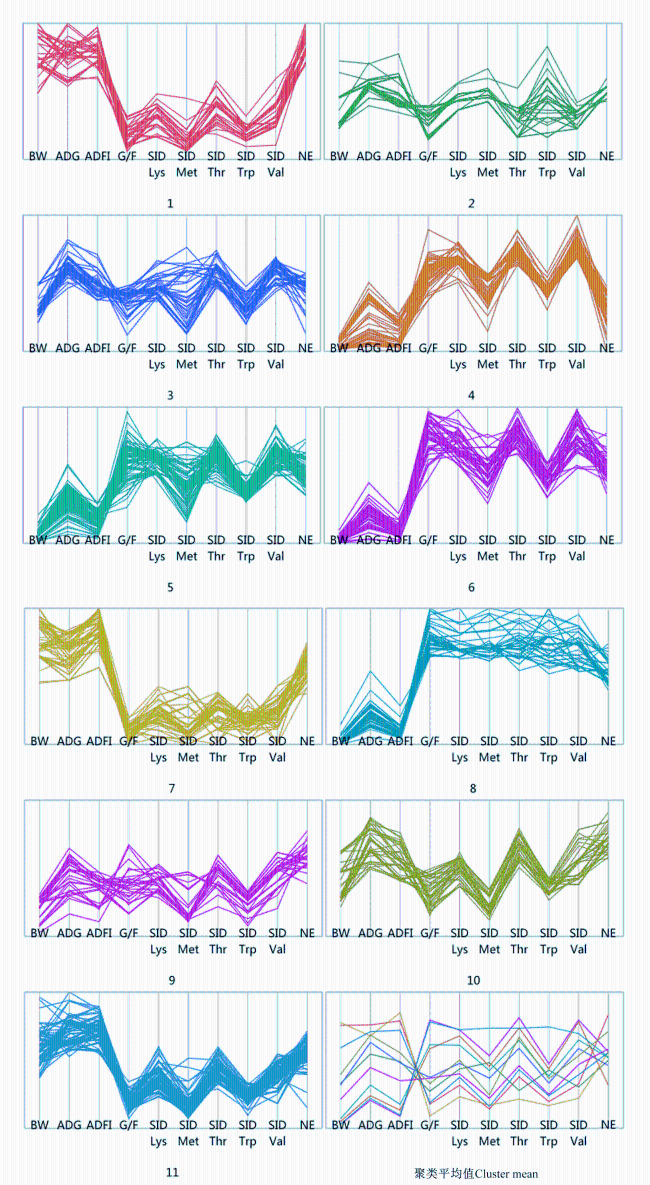
确定聚类数为11后,最终聚类结果如图4所示。通过平行图可直观了解各分类观测值在不同变量中的取值分布情况。图中每条连续线段分别对应着数据表中该分类的某一观测,且同类数据呈现出较高的集中趋势,表明聚类结果较为合理。
图4 不同类别数据的平行分布图

Fig.4 Parallel coordinate plot of different categories of data

2.3 数据建模

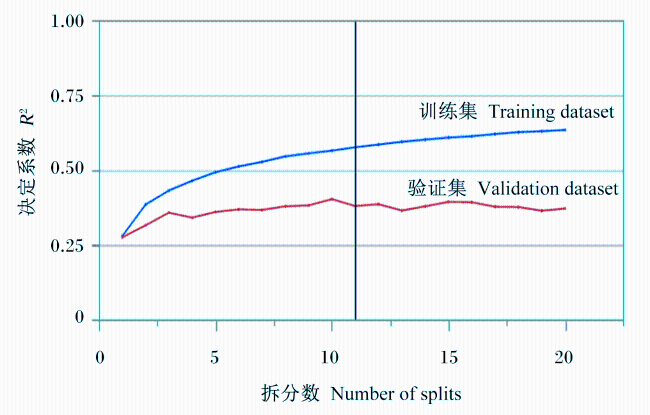
图5呈现了基于DT算法构建分类模型的拆分过程记录,由该图可知,训练集和验证集的R2随拆分系数的增加总体呈现上升趋势,最终趋于稳定。当拆分数为11时,DT分类模型达到最佳拟合效果,此时训练集和验证集的RMSE分别为0.576和0.596。确定最佳拆分数后,分别构建模型在训练集和验证集上分类结果的混淆矩阵,计算出训练集和验证集的MCR分别为0.412和0.481。
图5 最佳DT分类模型的拆分历史记录

Fig.5 Splitting history of the optimal DT classification model

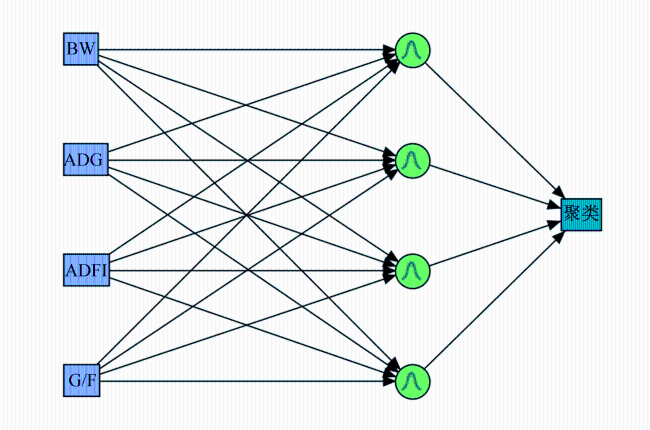
基于ANN构建分类模型时,将训练模型的其他参数设定成隐藏层数为1,学习率为0.1,惩罚方法为平方,历程数为100,通过改变节点数和激活函数训练分类模型,得到的训练集MCR及RMSE集合如表3所示。MCR及RMSE越小表示模型分类效果越好,因此当节点数为4且激活函数采用高斯径向基函数时,模型获得最小MCR值(0.410)与较小RMSE值(0.601),此时构建的分类模型拟合效果最佳,其结构如图6所示。
表3 不同节点数与激活函数的ANN模型分类效果

Table 3 Classification performance of ANN models with different numbers of nodes and activation functions

节点数
Number of nodes
激活函数Activation functions
双曲正切函数Hyperbolic tangent function 高斯径向基函数Gaussian radial basis function
误分类率MCR 均方根误差RMSE 误分类率MCR 均方根误差RMSE
1 0.542 0.677 0.517 0.675
2 0.448 0.625 0.447 0.624
3 0.450 0.640 0.417 0.615
4 0.422 0.619 0.410* 0.601*
5 0.430 0.610 0.432 0.596

*表示数据集中表现最佳的模型的相关拟合系数数值。

* indicates the value of the model correlation coefficient fit that performs best in the dataset.

图6 最佳ANN分类模型结构

Fig.6 Structure of the optimal ANN classification model

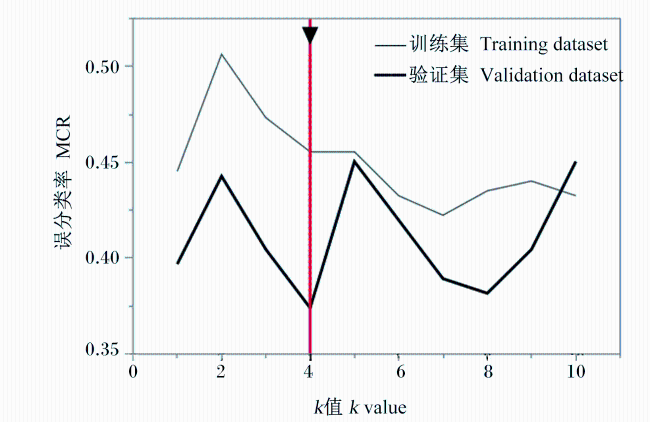
基于KNN构建分类模型训练时,固定随机种子为1,通过改变k值,训练集和验证集的MCR变化如图7所示。当k=4时,验证集的MCR达到最小值,为0.374,此时分类模型的拟合效果最佳。
图7 最佳KNN分类模型的拆分历史记录

Fig.7 Splitting history of the optimal KNN classification model

基于不同分类算法构建的模型训练结果如表4所示,通过比较DT、ANN和KNN 3种分类算法在验证集上所建模型的MCR,筛选出分类性能最优的模型及建模方法。
表4 3种模型分类效果的比较

Table 4 Comparison of classification performance among three models

项目
Items
决策树DT 人工神经网络ANN k-最近邻KNN
训练集
Training
dataset
验证集
Validation
dataset
训练集
Training
dataset
验证集
Validation
dataset
训练集
Training
dataset
验证集
Validation
dataset
参数Parameters 拆分数=11 节点数=4,高斯径向基函数 k=4
误分类率MCR 0.412 0.481 0.410 0.450 0.455 0.374
综上可知,表现最佳的分类模型为k=4时的KNN模型。由于个别类别推荐值对应的体重阶段数值相近,考虑到在实际生产应用中,相近体重下变更营养需要意义不大,因此基于该分类算法模型输出的类别以及k-均值聚类的结果,对相近体重推荐值的类别进行了合并。其中,类别1与类别7合并为类别1,类别2与类别3合并为类别2,类别6与类别8合并为类别6,最终得出8类瘦肉型生长育肥猪营养需要量推荐结果(表5)。类别代表聚类的类别,同时也对应着分类的结果,通过在分类算法模型中输入预期的体重数据,可获取对应的预测类别以及相应类别下推荐的营养需要量指标。该推荐标准是基于本研究收集的大量文献数据中饲粮营养水平与生长性能的关联性构建的,参照该表格中的营养需要量配制饲粮,可使生长育肥猪的生长性能平均值达到表格提供的参考水平。需要注意的是,表格中给出的体重为各类别的平均体重,具体推荐类别应以分类算法模型的分类结果为准。
表5 基于最佳分类算法模型的瘦肉型生长育肥猪营养需要量推荐值(干物质基础)

Table 5 Recommended nutrient requirements for lean-type growing-finishing pigs based on the optimal classification algorithm model (DM basis)

项目
Items
体重BW/kg
10.4 12.8 15.1 31.7 44.7 53.1 76.1 96.8
饲粮营养需要量Dietary nutrient requirements
净能NE/(MJ/kg) 10.82 10.23 10.76 10.93 10.65 11.27 10.86 11.14
标准回肠可消化赖氨酸SID Lys/% 1.45 1.38 1.26 0.93 1.02 1.09 0.88 0.71
标准回肠可消化蛋氨酸SID Met/% 0.64 0.51 0.48 0.33 0.48 0.35 0.28 0.28
标准回肠可消化苏氨酸SID Thr/% 0.72 0.70 0.64 0.52 0.52 0.66 0.50 0.40
标准回肠可消化色氨酸SID Trp/% 0.26 0.20 0.18 0.14 0.18 0.18 0.13 0.11
标准回肠可消化缬氨酸SID Val/% 0.85 0.88 0.79 0.67 0.67 0.72 0.62 0.54
每日营养需要量Daily nutrient requirements
净能NE/(MJ/d) 5.23 6.39 8.28 14.96 19.56 23.41 28.77 33.62
标准回肠可消化赖氨酸SID Lys/(g/d) 7.00 8.62 9.70 12.73 18.72 22.65 23.31 21.42
标准回肠可消化蛋氨酸SID Met/(g/d) 3.09 3.19 3.69 4.52 8.81 7.27 7.42 8.45
标准回肠可消化苏氨酸SID Thr/(g/d) 3.48 4.37 4.93 7.12 9.55 13.71 13.25 12.07
标准回肠可消化色氨酸SID Trp/(g/d) 1.26 1.25 1.39 1.92 3.30 3.74 3.44 3.32
标准回肠可消化缬氨酸SID Val/(g/d) 4.10 5.50 6.08 9.17 12.30 14.96 16.42 16.29
满足最低营养需要量时达到的生长性能Growth performance achieved when meeting the minimum nutrient requirements
平均日增重ADG/(g/d) 347.6 378.6 470.2 620.2 794.7 900.3 930.0 929.2
平均日采食量ADFI/(g/d) 482.8 624.8 769.7 1 368.6 1 835.6 2 077.8 2 649.0 3 017.0
增重耗料比G/F 0.73 0.60 0.62 0.47 0.44 0.44 0.35 0.31

每日营养需要量=饲粮营养需要量×ADFI。

Daily nutrient requirements=dietary nutrient requirements×ADFI.

3 讨论

3.1 数据采集

本试验通过元分析法从收集的文献中提取猪生长性能、饲粮NE和SID AA含量数据。经数据预处理后,首先采用k-均值聚类算法将数据聚集为11个类别;然后分别探究DT、ANN和KNN 3种机器学习算法在训练集和验证集上的最佳分类参数设置,并通过MCR进一步对3类最佳分类模型进行评估;最后筛选出的最佳分类模型为基于k-均值聚类的k=4的KNN模型,并据此提供了一套生长育肥猪营养需要量推荐标准。
本试验运用多元稳健拟合方法筛查离群值,并通过剔除离群值的数据预处理步骤,有效去除了异常数据,从而避免模型拟合效果偏离预测初衷。通过分析各变量分布的散点矩阵图,发现猪的体重、ADG、ADFI、G/F呈现较强的线性关系,而NE、SID Lys、SID Met、SID Thr、SID Trp、SID Val含量的线性相关性相对较弱。
这可能是由于多数研究中猪生长性能指标为实时监测数据,而试验饲粮虽设置不同营养水平梯度,但配方相对稳定,致使饲粮营养物质含量呈现静态不变的趋势。由此可知,针对NE和SID AA含量数据,构建简单线性模型的预测方法虽然简便易行,可解释性强,但预测效率可能欠佳[34]

3.2 k-均值聚类

本试验通过绘制CCC值与k值的关系图,直观地展示了CCC值随k值变化的趋势,进而辅助确定合适的k值。当k=11时聚类类别数适中,既能保证较高的分类准确度与精确度,又利于解构分类结果。综合考虑k值、CCC值及生产实际需求,最终选定k=11作为k-均值聚类的参数。除CCC值外,还可以结合轮廓系数(silhouette coefficient)和戴维斯-邦丁指数(Davis-bunding index)等其他指标来综合评估不同k值下的聚类效果[37-38]。从不同类别数据的平行分布图中可以观察到,11个类别中存在生长性能分类相似的组别,例如类别1与类别7、类别2与类别3以及类别6与类别8。因此,本试验在后续推荐的生长育肥猪营养需要量指标整合中,对生长性能相近的类别进行了平均合并处理。

3.3 基于DT、ANN和KNN 3种机器学习算法进行分类

采用传统回归方法估测营养需要量时,模型的数据维度和可纳入的影响因素较为有限,常需舍弃相关性较弱的影响因素,导致数据信息损失。而机器学习算法能充分利用这些数据信息,更契合行业智能化与现代化发展需求[39]。本研究在现行国内外常用猪营养需要量饲养标准的基础上,进一步细化分类阶段,旨在通过更科学的分类方法,得到不同体重阶段的NE和SID AA等营养需要量指标以及对应的ADG、ADFI和G/F等理想生产性能指标。
通过采用DT、ANN和KNN 3种机器学习算法对聚类后的生长性能和饲粮营养水平数据进行分类,结果表明,ANN算法分类稳定性较好,验证集MCR较训练集增加了9.76%;DT算法分类稳定性次之,其在训练集上的分类表现与ANN算法相近,但其验证集MCR较训练集增加了16.75%,说明ANN算法较DT算法更适合于本试验条件下生长性能和饲粮营养水平数据的分类;KNN算法的分类稳定性较差,验证集MCR较训练集降低了17.80%,但其验证集MCR为3种算法中最佳,显示出更强的泛化能力。考虑到实际应用中模型的泛化能力更为重要,因此我们最终选择KNN作为推荐算法。KNN算法遵循一种直接的方法来拟合观测的近似值从而构建目标函数[40],其学习过程属于懒惰学习,仅存储训练数据。预测新输入向量的输出值时,算法会从模型内已有的训练数据中检索相似观测并聚合输出结果,这与ANN等仅构建目标函数局部近似值的技术在原理上存在本质差异[41]。基于实例的预测算法的显著优势是,对于每个新观测值,模型都可以构建目标函数的新近似值,从而能够捕获属性和结果之间非常复杂的关系[42]。然而,这类方法也存在一些弊端,即分类成本远高于其他方法,因为所有计算都是通过分类而非训练时执行的,且若目标变量仅依赖于少数属性,可能导致模型对相似实例的预测值与实际值偏差较大,造成数据拟合效果欠佳[43]。与DT和ANN模型不同,KNN模型的复杂性随着k值的增大而降低,k值越小,模型越复杂。这一点与DT和ANN等函数依赖的算法模型相反。在本试验中,DT和ANN模型的拟合效果随参数变化的图表显示,当模型拆分数或节点数达到一定范围后,随着参数的增大,代表模型拟合效果的R2虽有上升,但总体上升趋势不大。这意味着在该参数区间内,不同参数对模型在数据集中的拟合效果影响较小。然而,随着模型复杂性的增加,过拟合的风险也会随之上升。因此,仅以模型在验证集上的拟合效果指标(如R2和RMSE)来选择最适模型可能并不合理。后续试验中,有必要通过交叉验证和测试集评估来进一步验证模型性能,特别是对模型在样本外数据集上的拟合情况进行测试,以确定更具泛用性的参数设置。

3.4 不同类别下的营养需要量推荐值

本研究得出的营养需要量推荐值与《猪营养需要量》(GB/T 39235—2020)[18]中不同体重阶段的生长育肥猪营养需要量存在一定差异,其中NE的差异最为明显,这可能是多种因素共同作用的结果。本研究确定生长育肥猪营养需要量推荐值的方法与Dhal等[13]研究水培灌溉植物营养需要量推荐值的方法相似,均是依据聚类和分类结果整合得出推荐需要量。然而,Dhal等[13]的研究样本数据源自实际生产实验,但因数据量有限,模型拟合效果一般,仅得出2类推荐指标;而本研究结合生产实际,给出了11类(整合为8类)指标,这无疑对样本数据的体量和质量提出了更高要求。为增加数据量,本研究采用类似元分析的方法收集文献数据,存在数据质量不佳的风险[44]。且部分选取文献的试验周期较长,为了方便饲喂未根据不同生长阶段设计多段饲粮,导致饲粮营养水平整体偏高,这可能影响了营养需要量的推荐数据取值。此外,选取的文献时间跨度较长,未考虑育种技术等遗传因素的影响;若缩短时间跨度,数据量又不足,可能会对模型效果产生更大的负面影响。因此,本研究在营养需要量推荐标准(表5)中增加了每日营养需要量类别。这是因为每日营养需要量是固定值,便于灵活计算具体试验动物所需的采食量和营养物质含量。具体来说,可以依据每日能量摄入需要量和配制的饲粮能量水平计算日采食量,再依据该采食量和每日营养需要量计算饲粮营养物质含量。此外,在本文纳入的营养需要量推荐指标中,NE作为最精确的能量评价指标[45],测定难度大且操作复杂,难以在短时间内通过饲养试验获得大量数据。为增加样本量和不同来源数据之间的可比性,本研究中的NE数据均通过计算得出,这也可能会带来一定的误差。更加精准的推荐需要量数值,需要更大体量的饲粮营养水平数据和长期的饲养试验作为支撑。此外,本研究中体重阶段的设置也与NRC(2012)[46]及我国《猪营养需要量》(GB/T 39235—2020)[18]存在较大差异,后两者体重阶段划分均为基于生产经验进行人为划分,如NRC(2012)将生长育肥猪的体重阶段标准划分为5~7 kg、7~11 kg、11~25 kg、25~50 kg、50~75 kg、75~100 kg和100~135 kg,而我国《猪营养需要量》(GB/T 39235—2020)将生长育肥猪的体重阶段划分为3~8 kg、8~25 kg、25~50 kg、50~75 kg、75~100 kg和100~120 kg,以上均无准确的分类参考依据。而本研究则在整理大量数据的基础上,采用机器学习中的分类算法对体重阶段进行分类并确定对应的营养需要量,是利用机器学习建立科学饲养标准的基础性探索。然而,受限于原始文献质量参差不齐及数据集维度和体量的不足,研究结果在精准度和普适性上与国内外现行猪饲养标准仍存在差距,但该方法的可行性表明机器学习算法在营养需要量研究领域前景广阔。随着行业进步和智能数据采集手段的不断进步,该方法在普适性和精准度方面还有极大的提升空间。后续也考虑将不同饲养模式、猪群饲养密度、环境温度等更多维度、更大体量的数据纳入数据集,对现有模型进行优化,提高模型准确性和普适性。因此,相较于给出精准的推荐结果,本试验更侧重于探索出最适用于营养需要量预测的机器学习方法,以期为后续基于长期积累的实测生产数据优化算法模型及与精准饲喂设备联动的生产应用奠定研究基础。

4 结论

本试验基于文献数据,对DT、ANN和KNN 3种机器学习算法在构建猪营养需要量分类模型中的应用表现进行了探究,发现采用KNN算法构建的分类模型的分类效果最佳。基于该模型的输出结果以及k-均值聚类分类结果,整合出了一套生长育肥猪营养需要量推荐标准。期望在未来的研究中能够采集到更精细化饲喂的试验数据,用于聚类和分类模型构建,并对模型在样本外数据集上的拟合情况进行测试,以确定更具泛用性的分类模型的参数设置。
[1]
符林升, 熊本海. 猪营养需要量动态预测系统的开发[J]. 农业网络信息, 2009,7:9-12.

FU L S, XIONG B H. Development of dynamic projection system for nutrient requirements of swine[J]. Agriculture Network Information, 2009,7:9-12. (in Chinese)

[2]
PEDERSEN C, BOISEN S. Establishment of tabulated values for standardized ileal digestibility of crude protein and essential amino acids in common feedstuffs for pigs[J]. Acta Agriculturae Scandinavica Section A-Animal Science, 2002, 52(3):121-140.

[3]
URBAITYTE R, MOSENTHIN R, EKLUND M. The concept of standardized heal amino acid digestibilities:principles and application in feed ingredients for piglets[J]. Asian-Australasian Journal of Animal Sciences, 2009, 22(8):1209-1223.

[4]
席鹏彬. 中国地方菜籽饼粕组成特点及猪回肠氨基酸消化率的研究[D]. 博士学位论文. 北京: 中国农业大学, 2002.

XI P B. Composition characteristics and ileal amino acid digestibility of Chinese rapeseed meals in growing pigs[D]. Ph.D.Thesis. Beijing: China Agricultural University, 2002. (in Chinese)

[5]
ŚWIECH E. Alternative prediction methods of protein and energy evaluation of pig feeds[J]. Journal of Animal Science and Biotechnology, 2017,8:39.

[6]
张帅, 刘岭, 王凤来, 等. 猪饲料原料营养价值与动态营养需要量模型化研究进展[J]. 动物营养学报, 2020, 32(10):4525-4539.

DOI

ZHANG S, LIU L, WANG F L, et al. Research progress on modeling of nutrient values and dynamic nutrient requirements of pig feed ingredients[J]. Chinese Journal of Animal Nutrition, 2020, 32(10):4525-4539. (in Chinese)

[7]
侯磊. 无抗饲粮蛋白质水平对仔猪生长、肠道健康和养分沉积的影响[D]. 博士学位论文. 哈尔滨: 东北农业大学, 2021.

HOU L. Effects of protein level on growth,intestinal health and nutrient deposition of piglets fed antibiotic-free diets[D].Ph.D.Thesis. Harbin : Northeast Agricultural University, 2021. (in Chinese)

[8]
HOU L, WANG L, QIU Y Q, et al. Effects of protein restriction and subsequent realimentation on body composition,gut microbiota and metabolite profiles in weaned piglets[J]. Animals, 2021, 11(3):686.

[9]
黄瑞林, 丁婧, 冯泽猛, 等. 生猪动态营养需求研究现状及发展路径探讨[J]. 动物营养学报, 2022, 34(10):6132-6145.

DOI

HUANG R L, DING J, FENG Z M, et al. Research status and development path exploration of dynamic nutritional requirements of pig[J]. Chinese Journal of Animal Nutrition, 2022, 34(10):6132-6145. (in Chinese)

[10]
WANG L, SHI H W, HU Q L, et al. Modeling net energy partition patterns of growing-finishing pigs using nonlinear regression and artificial neural networks[J]. Journal of Animal Science, 2023,101:skac405.

[11]
SABERI-KARIMIAN M, KHORASANCHI Z, GHAZIZADEH H, et al. Potential value and impact of data mining and machine learning in clinical diagnostics[J]. Critical Reviews in Clinical Laboratory Sciences, 2021, 58(4):275-296.

[12]
SARKER I H. Machine learning:algorithms,real-world applications and research directions[J]. SN Computer Science, 2021, 2(3):160.

[13]
DHAL S B, BAGAVATHIANNAN M, BRAGA-NETO U, et al. Nutrient optimization for plant growth in aquaponic irrigation using machine learning for small training datasets[J]. Artificial Intelligence in Agriculture, 2022,6:68-76.

[14]
ADIDRANA D, SURANTHA N. Hydroponic nutrient control system based on internet of things and k-nearest neighbors[C]// 2019 International Conference on Computer,Control,Informatics and its Applications (IC3INA). Indonesia:IEEE,2019:166-171.

[15]
QASRAWI R, BADRASAWI M, AL-HALAWA D A, et al. Identification and prediction of association patterns between nutrient intake and anemia using machine learning techniques:results from a cross-sectional study with university female students from Palestine[J]. European Journal of Nutrition, 2024, 63(5):1635-1649.

[16]
SAK J, SUCHODOLSKA M. Artificial intelligence in nutrients science research:a review[J]. Nutrients, 2021, 13(2):322.

[17]
KIRK D, KOK E, TUFANO M, et al. Machine learning in nutrition research[J]. Advances in Nutrition, 2022, 13(6):2573-2589.

DOI PMID

[18]
国家市场监督管理总局, 国家标准化管理委员会. 猪营养需要量:GB/T 39235—2020[S]. 北京: 中国标准出版社, 2020.

State Administration for Market Regulation, Standardization Administration of the People’s Republic of China. Nutrient requirements of swine:GB/T 39235—2020[S]. Beijing: Standards Press of China, 2020. (in Chinese)

[19]
李雄英, 王斌会. 稳健均值-方差模型的构建及比较研究[J]. 统计与决策, 2020, 36(13):47-52.

LI X Y, WANG B H. Construction and comparative research of robust mean-variance model[J]. Statistics and Decision, 2020, 36(13):47-52. (in Chinese)

[20]
OSBORNE J W, OVERBAY A. The power of outliers (and why researchers should always check for them)[J]. Practical Assessment,Research,and Evaluation, 2004, 9(1):6.

[21]
WILKINSON L. Visualizing big data outliers through distributed aggregation[J]. IEEE Transactions on Visualization and Computer Graphics, 2018, 24(1):256-266.

[22]
SINGH D, SINGH B. Investigating the impact of data normalization on classification performance[J]. Applied Soft Computing, 2020,97:105524.

[23]
DE MAESSCHALCK R, JOUAN-RIMBAUD D, MASSART D L. The Mahalanobis distance[J]. Chemometrics Intelligent Laboratory Systems, 2000, 50(1):1-18.

[24]
MAHMUD S K, BINTI H R, TUSNIA T Z, et al. When to use standardization and normalization:empirical evidence from machine learning models and XAI[J]. IEEE Access, 2024,12:135300-135314.

[25]
CABELLO-SOLORZANO K, DE ARAUJO I O, PEÑA M, et al. The impact of data normalization on the accuracy of machine learning algorithms:a comparative analysis[M]//18th International Conference on Soft Computing Models in Industrial and Environmental Applications. Cham:Springer,2023:344-353.

[26]
ALI P J M, FARAJ R H. Data normalization and standardization:a technical report[J]. Machine Learning Technical Reports, 2014, 1(1):1-6.

[27]
BÔTO J M, MARREIROS A, DIOGO P, et al. Health behaviours as predictors of the Mediterranean diet adherence:a decision tree approach[J]. Public Health Nutrition, 2022, 25(7):1864-1876.

[28]
MILANOVIĆ M, STAMENKOVIĆ M. CHAID decision tree:methodological frame and application[J]. Economic Themes, 2016, 54(4):563-586.

[29]
AZAD M, CHIKALOV I, HUSSAIN S, et al. Entropy-based greedy algorithm for decision trees using hypotheses[J]. Entropy, 2021, 23(7):808.

[30]
GARCÍA L R, FERNÁNDEZ A A, MANCUSO V, et al. A novel hyperparameter-free approach to decision tree construction that avoids overfitting by design[J]. IEEE Access, 2019,7:99978-99987.

[31]
LI Y H. Classifiability-based omnivariate decision trees[J]. IEEE Transactions on Neural Networks, 2005,16:1547-1560.

[32]
ABRAHAM A. Meta learning evolutionary artificial neural networks[J]. Neurocomputing, 2004,56:1-38.

[33]
KARLIK B, OLGAC A V. Performance analysis of various activation functions in generalized MLP architectures of neural networks[J]. International Journal of Artificial Intelligence and Expert Systems, 2010, 1(4):111-122.

[34]
HUYSMANS J, DEJAEGER K, MUES C, et al. An empirical evaluation of the comprehensibility of decision table,tree and rule based predictive models[J]. Decision Support Systems, 2011, 51(1):141-154.

[35]
MUCHERINO A, PAPAJORGJI P J, PARDALOS P M. K-nearest neighbor classification[M]// MUCHERINOA, PAPAJORGJIP J, PARDALOSP M. Datamining in agriculture. New York: Springer, 2009.

[36]
PAI D R, LAWRENCE K D, KLINNBERG R K, et al. Analyzing the balancing of error rates for multi-group classification[J]. Expert Systems with Applications, 2012, 39(17):12869-12875.

[37]
REZANKOVÁ H. Different approaches of the silhouette coefficient calculation in cluster evaluation[C]//21st International Scientific Conference on Applications of Mathematics and Statistics in Economics (AMSE). Kutná Hora: Applications of Mathematics and Statistics in Economics Conference Proceedings,2018:259-268.

[38]
ROY P, MANDAL J K. Performance evaluation of some clustering indices[M]// JAINL C, BEHERAH S, MANDALJ K, et al. Computational intelligence in data mining-volume 3.New Delhi:Springer,2014:509-517.

[39]
王力. 基于机器学习的生长育肥猪净能需要量动态预测模型研究[D]. 博士学位论文. 北京: 中国农业大学,2023:12-19.

WANG L. Study on the dynamic prediction models of net energy requirement in growing-finishing pigs based on machine learning[D]. Ph.D.Thesis. Beijing: China Agricultural University,2023:12-19. (in Chinese)

[40]
AHUJA R, CHUG A, GUPTA S, et al. Classification and clustering algorithms of machine learning with their applications[M]// YANGX S, HEX S.Nature-inspired computation in data mining and machine learning. Cham:Springer, 2020.

[41]
ARUNADEVI M, RANI M, SIBINRAJ R, et al. Comparison of k-nearest neighbor & artificial neural network prediction in the mechanical properties of aluminum alloys[J]. Materials Today:Proceedings,2023:111.

[42]
ZHU H, WANG X Z, WANG R. Fuzzy monotonic k-nearest neighbor versus monotonic fuzzy k-nearest neighbor[J]. IEEE Transactions on Fuzzy Systems, 2022, 30(9):3501-3513.

[43]
TRIGUERO I, GARCÍA-GIL D, MAILLO J, et al. Transforming big data into smart data:an insight on the use of the k-nearest neighbors algorithm to obtain quality data[J]. Wiley Interdisciplinary Reviews.Data Mining and Knowledge Discovery, 2019, 9(2):e1289.

[44]
LEE Y H. Strengths and limitations of Meta-analysis[J]. Korean Journal of Medicine, 2019, 94(5):391-395.

[45]
LI Z C, LIU H, LI Y K, et al. Methodologies on estimating the energy requirements for maintenance and determining the net energy contents of feed ingredients in swine:a review of recent work[J]. Journal of Animal Science and Biotechnology, 2018,9:39.

[46]
NRC. Nutrient requirements of swine[S]. 12th ed.Washington,D. C.:The National Academies Press, 2012.

Outlines

/